Jeden mikrokontroler ma za mało pamięci, żeby pomieścić model językowy z setkami milionów parametrów. Low-Zi-Hong, autor opublikowanego na GitHubie projektu ESP32s3-LLM-Cluster, obszedł to ograniczenie najprostszym możliwym sposobem: pokroił model na kawałki i każdy z nich wgrał na osobną płytkę. Powstał rozproszony silnik inferencji, czyli program, który z gotowych wag modelu wylicza kolejne słowa odpowiedzi – tyle że zamiast jednego procesora pracuje w nim siedem układów ESP32-S3.
Master i sześć węzłów w łańcuchu
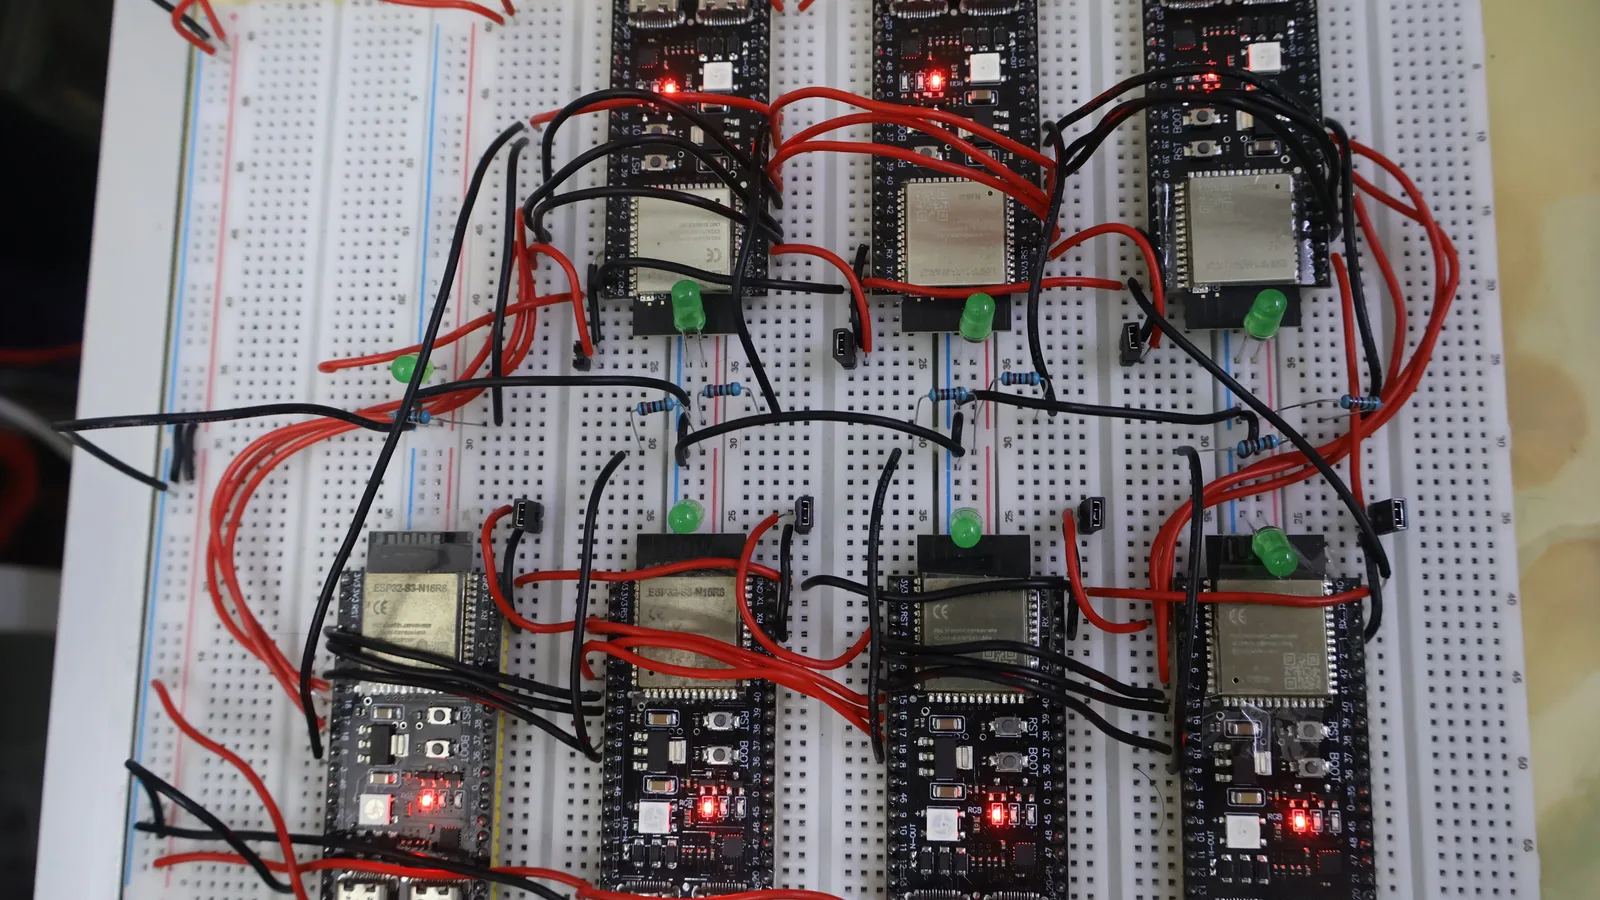
Jedna płytka pełni rolę mastera, sześć pozostałych to węzły obliczeniowe. Połączono je w łańcuch (daisy-chain) magistralą SPI: każda płytka ma dwa kanały, jednym odbiera dane od poprzedniej, drugim wysyła je do następnej, a ostatni węzeł oddaje wynik z powrotem masterowi.
Podział pracy wygląda tak:
- master zamienia wpisany tekst na tokeny (tokenizer BPE), a tokeny na wektory liczb (embeddingi). Po powrocie danych z łańcucha wykonuje końcową normalizację i wybiera następny token – zawsze ten najbardziej prawdopodobny (tzw. próbkowanie zachłanne),
- każdy węzeł liczy cztery kolejne warstwy transformera: węzeł pierwszy warstwy 0–3, drugi 4–7 i tak dalej, aż do warstw 20–23 na węźle szóstym.
Między płytkami wędruje tylko tzw. stan ukryty – wektor 896 liczb zmiennoprzecinkowych. W kodzie zegar SPI ustawiono na 10 MHz. Oprócz linii danych łańcuch spinają dwa sygnały sterujące: master przy starcie resetuje węzły, a ostatni z nich zgłasza mu gotowość całego klastra. Wszystkie płytki muszą mieć wspólną masę.
Jak zmieścić Qwen2 w 16 MB
Punktem wyjścia jest architektura Qwen2-0.5B z 24 warstwami. Żeby zmieściła się w pamięci płytek – użyto modułów ESP32-S3-N16R8, czyli z 16 MB pamięci Flash i 8 MB PSRAM – przeszła trzy zabiegi.
Po pierwsze, wagi warstw liniowych skwantyzowano do 1,58 bita. Oznacza to, że każda waga może przyjąć tylko jedną z trzech wartości: -1, 0 albo 1 – to pomysł znany z projektu BitNet Microsoftu. Cztery takie wagi mieszczą się w jednym bajcie, dzięki czemu jedna warstwa zajmuje około 3,82 MB, a cztery warstwy jednego węzła – około 15,3 MB.
Po drugie, słownik przycięto ze 151 tys. do 32 tys. tokenów. Większy nie zmieściłby się w pamięci mastera: same embeddingi, zapisane z dokładnością 4 bitów (INT4), zajmują około 14 MB. Po tych cięciach model ma około 0,4 mld parametrów.
Po trzecie, mnożenie przez wagi trójwartościowe napisano w asemblerze z użyciem wektorowych instrukcji ESP32-S3, a pamięć podręczną kontekstu (KV cache), pozwalającą pracować z oknem do 512 tokenów, umieszczono w dodatkowej pamięci PSRAM każdego węzła.
Wolno, ale oszczędnie
Każdy węzeł potrzebuje obecnie około 1,3 s na swoją część obliczeń. Ponieważ dane przechodzą przez płytki po kolei, czasy się sumują – przy sześciu węzłach wychodzi blisko 8 sekund na jeden token. W firmware domyślna długość odpowiedzi jest ustawiona testowo na 20 tokenów.
Pobór mocy jest za to symboliczny. Sześć węzłów zasilanych z zasilacza laboratoryjnego napięciem 5 V pobiera około 1,2 W w spoczynku i około 1,5 W podczas generowania; master jest zasilany z portu USB komputera.
Architektura daje się rozbudowywać: każda dodatkowa płytka to kolejne cztery warstwy modelu. Ceną jest czas, który rośnie liniowo z liczbą węzłów.
Model jeszcze nie mówi z sensem
Najważniejsze zastrzeżenie jest zapisane wprost w dokumentacji projektu. Model po tak mocnej kwantyzacji trzeba dotrenować (QAT – trening uwzględniający kwantyzację), a dołączony skrypt robi to tylko częściowo: funkcja straty zatrzymuje się w okolicach 8,0 i klaster wypisuje praktycznie losowe tokeny. Kto ma mocniejszy komputer, może dokończyć trening samodzielnie – wszystkie narzędzia w Pythonie są w repozytorium.
To więc działający dowód koncepcji: sprzęt, komunikacja i obliczenia są gotowe, brakuje dobrze wytrenowanych wag. Dokumentacja ostrzega też przed dwiema pułapkami, które nie kończą się żadnym błędem, a jedynie bezsensownym wynikiem: wgraniem warstw na płytkę stojącą w niewłaściwym miejscu łańcucha oraz niezgodnością sposobu pakowania wag między skryptem treningowym a kodem na mikrokontrolerze.
Zabawa czy coś więcej
Projekt trafił na forum Elektroda.pl i do serwisu Hacker News. W dyskusjach przeważa sympatia połączona ze sceptycyzmem: przy takim stopniu kompresji model jest na razie „wymyślnym generatorem szumu”, a wąskim gardłem modeli językowych jest przepustowość pamięci, więc rozkładanie ich na wiele małych układów nie jest efektywne. Padają też porównania do dawnych klastrów Beowulf i uwagi, że do lokalnego uruchamiania modeli lepiej nadaje się mini PC albo płytka z układem RK3588.
Jako ćwiczenie z kwantyzacji, asemblera i komunikacji między mikrokontrolerami klaster broni się jednak sam. Kod, skrypty do przygotowania modelu i schemat połączeń udostępniono na licencji MIT.
Artykuł powstał na podstawie wpisu na forum Elektroda.pl oraz dokumentacji projektu ESP32s3-LLM-Cluster.